-
통찰력 있는 사람들이 함께하는 젊고 열정적인 IT 기업, 비젠소프트.
A young and passionate technology company,
brought together by people with keen insight—this is Vizensoft.
 Back
ElevenLabs Scribe v3, 녹음·실시간 받아쓰기에서 달라진 정확도와 화자 구분
ElevenLabs Scribe v3, 녹음·실시간 받아쓰기에서 달라진 정확도와 화자 구분 - 녹음 파일용 Scribe v3와 실시간용 Scribe v3 Live를 같은 숫자로 묶
 47
녹음 파일용 Scribe v3와 실시간용 Scribe v3 Live를 같은 숫자로 묶지 않고 고르는 법 — 2026년 11월 공개 기준
회의록을 만들거나, 콜센터 통화를 기록하거나, 인터뷰 영상에 자막을 붙이는 일을 맡고 있다면 ElevenLabs Scribe v3의 공개 소식이 반가울 만합니다. 다만 이번 발표는 모델 하나가 아니라 두 개입니다. 녹음 파일용 Scribe v3와 실시간용 Scribe v3 Live입니다. 이 둘은 쓰는 통로도, 숫자를 재는 방식도, 화자 구분이 동작하는 방식도 다릅니다.
이 글은 두 모델을 같은 저울에 올려놓지 않는 방법을 다룹니다. 결론부터 말하면 다음과 같습니다.
이미 녹음된 파일을 정리하는 일이라면 Scribe v3, 말이 오가는 동안 화면에 바로 띄워야 한다면 Scribe v3 Live가 맞습니다. 그리고 어느 쪽이든 회사가 공개한 정확도 수치는 ElevenLabs가 자체 평가로 낸 값이므로, 내 녹음 환경에서 직접 확인하는 절차가 필요합니다. 기존 Scribe v2와 v2 Realtime도 계속 제공되므로, 갈아타는 시점은 서두를 이유 없이 검증을 마친 뒤에 정하면 됩니다.
STT 서비스 전반의 자동 전사·화자 분리 설정법이나 음성 AI 시장 전체의 실시간·배치 비교는 이미 다룬 바 있어 여기서는 반복하지 않습니다. 이 글은 두 모델의 벤치마크 산정 차이와, 실시간 화자 라벨이 확정되고 수정되는 흐름에 집중합니다.
두 모델을 비교하기 전에 정해야 할 다섯 가지 기준
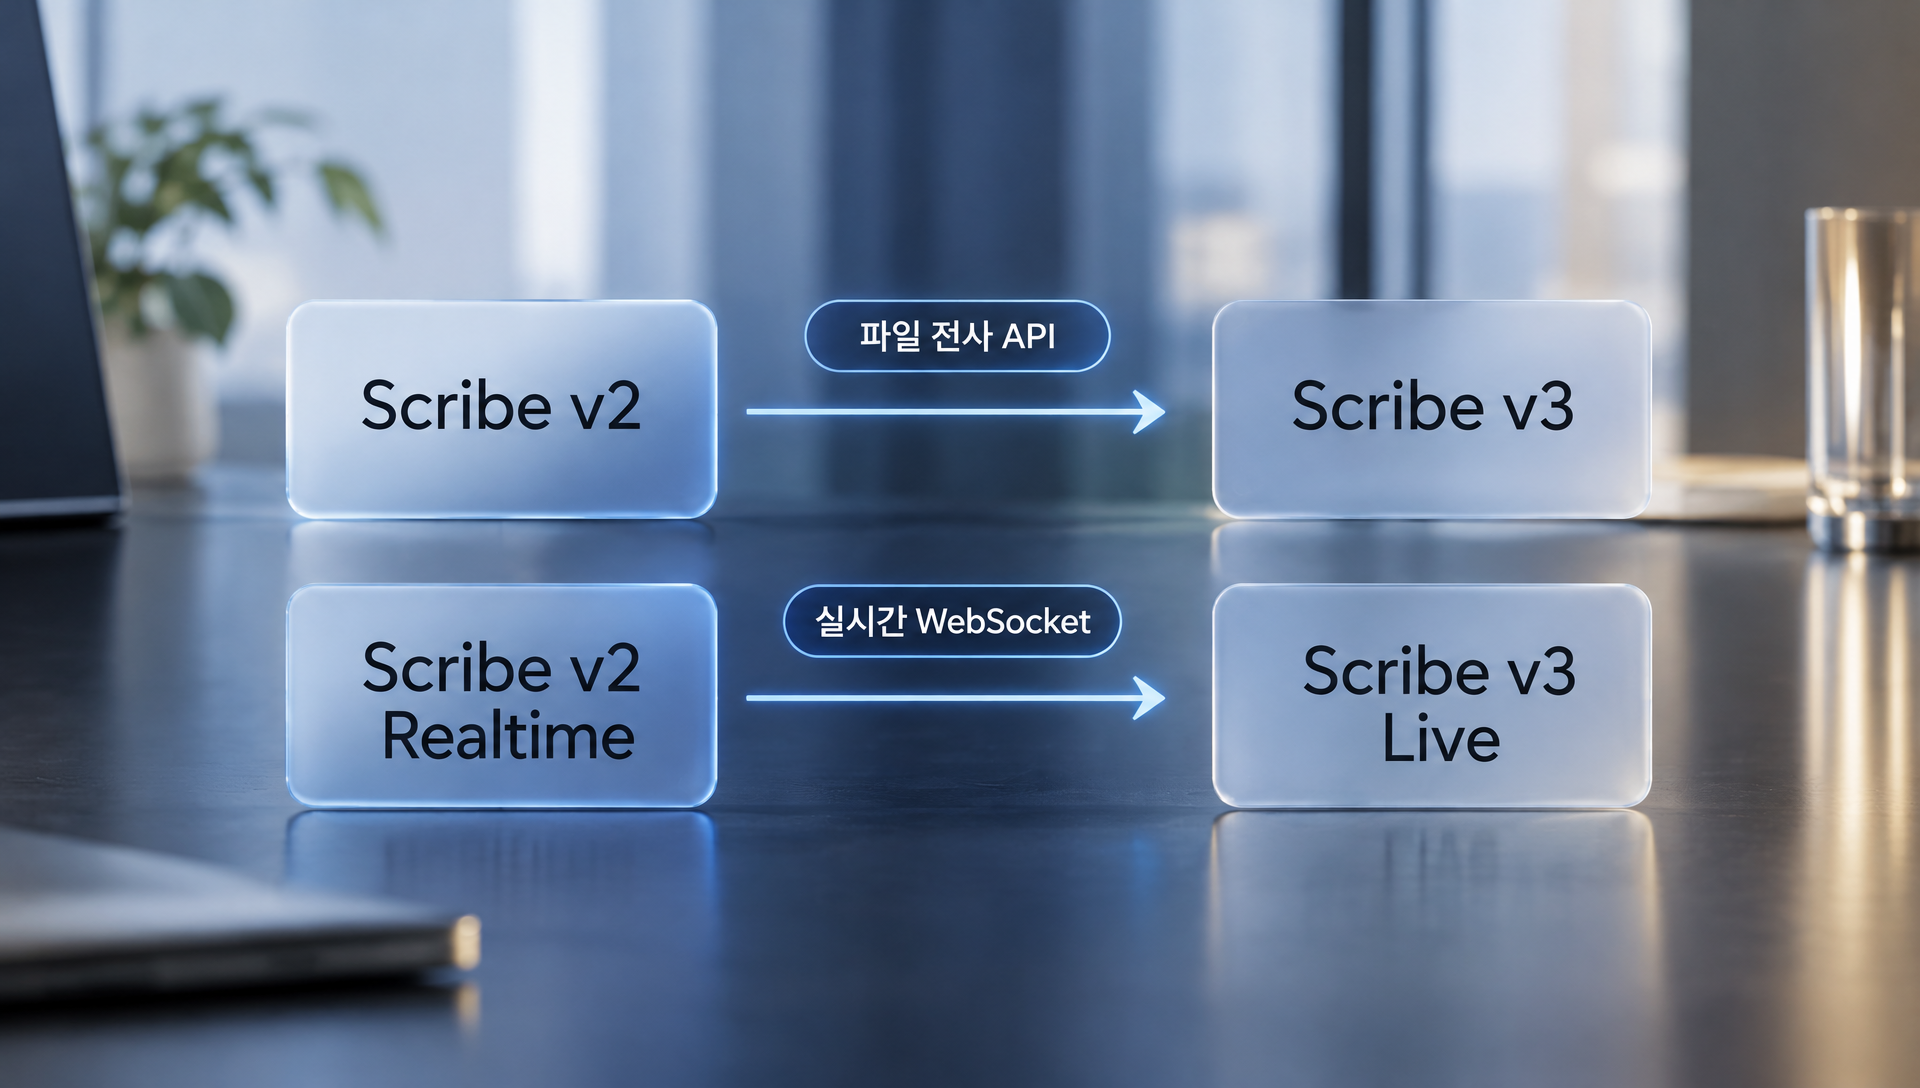
두 모델은 후속 관계가 서로 다르기 때문에, 비교 기준부터 나눠야 합니다. 공식 모델 문서는 Scribe v3를 기존 Scribe v2의 후속으로, Scribe v3 Live를 Scribe v2 Realtime의 후속으로 안내합니다. 녹음용은 파일 전사 API를, 실시간용은 WebSocket을 씁니다. 즉 "v3 대 v3 Live"가 아니라 "v2 대 v3", "v2 Realtime 대 v3 Live"라는 두 개의 세대교체로 읽는 편이 정확합니다.
이 글에서는 다음 다섯 기준으로 두 선택지를 살펴봅니다. 점수나 가중치는 매기지 않습니다.
① 처리 방식: 파일을 통째로 올리는가, 소리가 들어오는 동안 이어서 받는가
② 정확도 근거: 어떤 데이터셋에서 어떤 방식으로 계산한 숫자인가, 외부 측정이 있는가
③ 화자 구분: 몇 명까지 지원하고, 라벨이 언제 확정되는가
④ 용어·언어 입력: 전문 용어를 몇 개까지 지정하고, 언어 전환을 어떻게 다루는가
⑤ 데이터 처리 위치: 어디에서 처리되고, 보관은 어떻게 되는가
정확도 숫자를 볼 때 특히 조심할 점이 있습니다. 회사는 FLEURS 평가에서 클립별로 WER(단어 오류율)을 계산한 뒤 언어별로 평균을 내는 방식을 쓴다고 밝히며, 다른 방식으로 산출한 벤치마크와는 직접 비교할 수 없다고 명시합니다. 이 글에서도 서로 다른 평가 방식의 숫자를 한 줄로 세우지 않습니다.
녹음 파일용 Scribe v3: 정확도 개선과 32명 화자 구분
Scribe v3는 이미 끝난 녹음을 정리하는 용도에서 근거가 가장 풍부한 선택지입니다. 회사 자체 평가와 외부 측정이 모두 있고, 두 측정 모두 v2보다 나아졌다는 같은 방향을 가리킵니다. 다만 두 숫자는 기준이 달라 서로 대체하지 못합니다.
회사 평가: 102개 언어에서 WER 16.94%에서 12.38%로
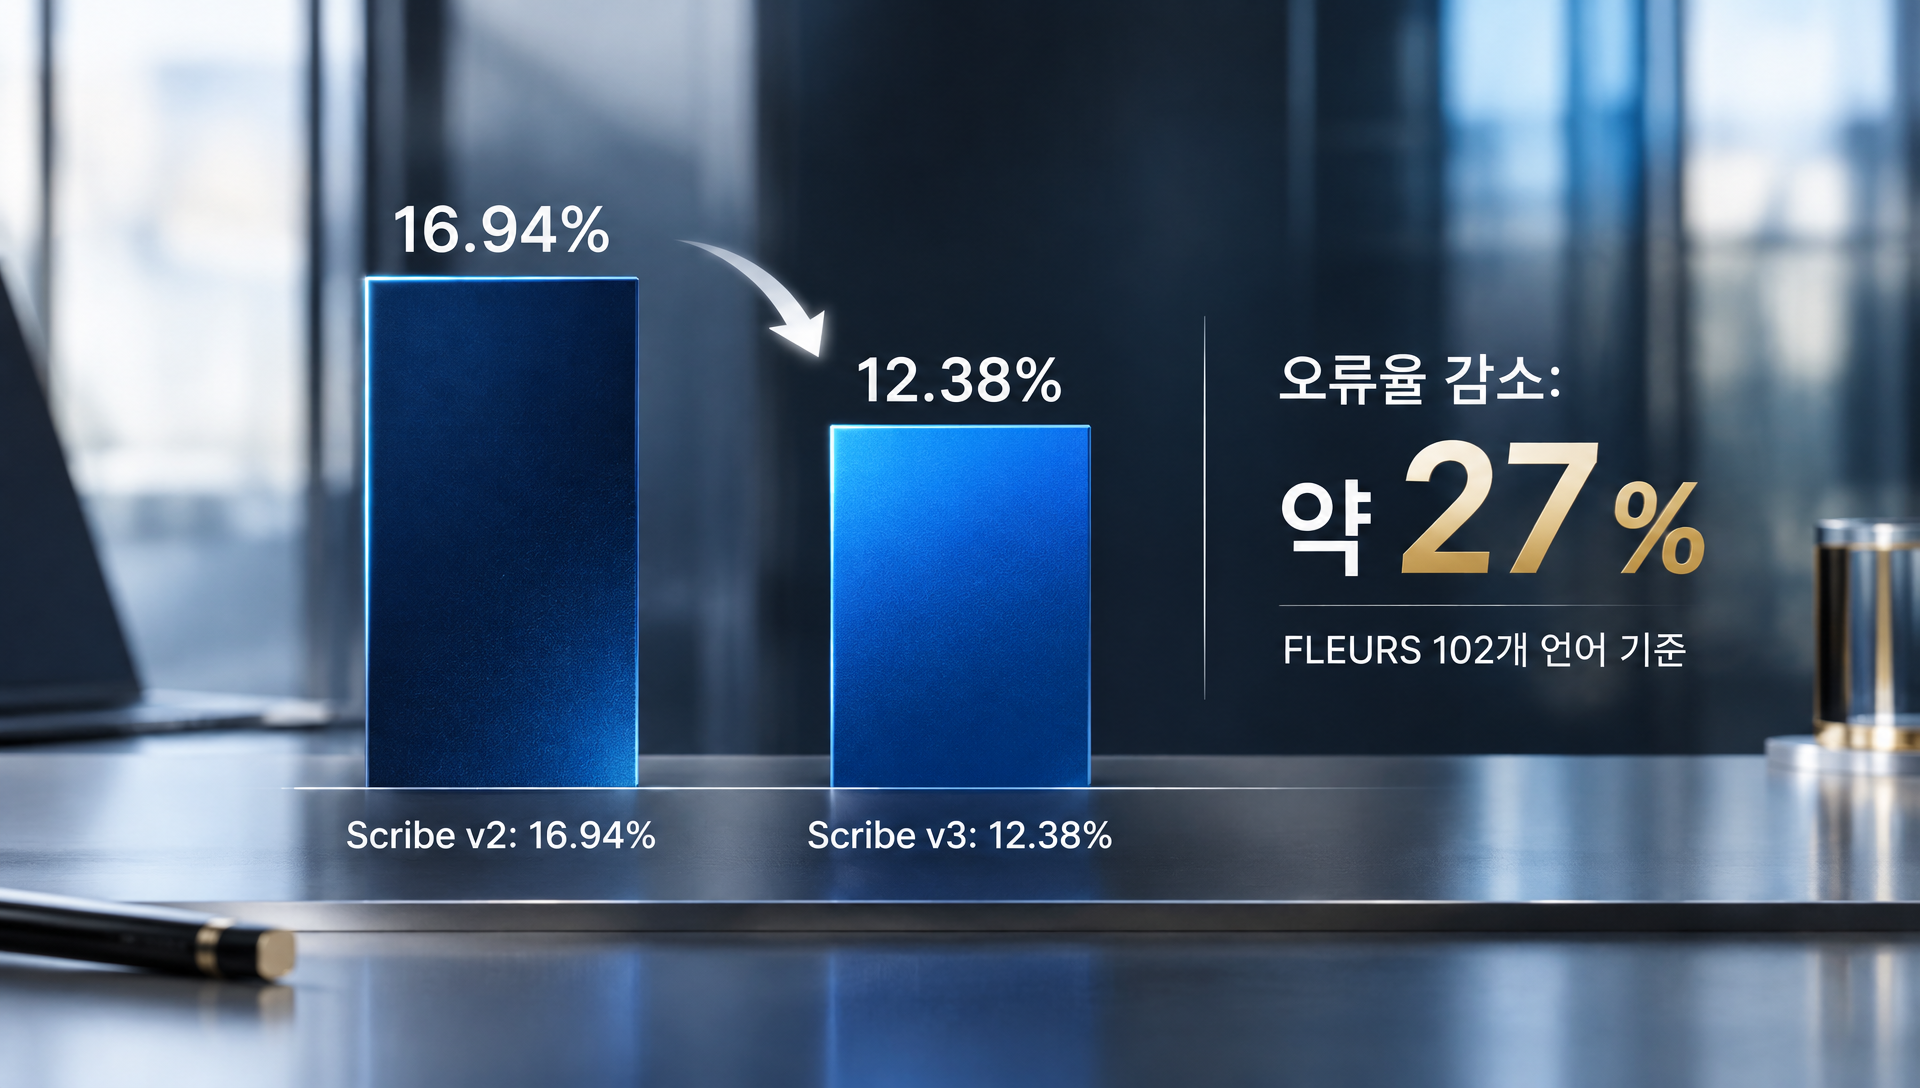
ElevenLabs는 FLEURS 평가에서 Scribe v3의 102개 언어 평균 WER이 Scribe v2의 16.94%에서 12.38%로 낮아졌다고 발표했습니다. 오류율로는 약 27% 감소입니다. 앞서 말한 대로 클립별 WER을 먼저 구한 뒤 언어별로 평균을 낸 값이므로, 다른 곳에서 가져온 WER 숫자와 나란히 놓고 우열을 말하기는 어렵습니다.
이 숫자가 알려 주는 것은 "다양한 언어를 다루는 평균적인 환경에서 v2보다 오류가 줄었다"는 정도입니다. 한 가지 언어, 특정 업계 용어, 잡음이 많은 현장 녹음에서 얼마나 줄었는지는 별개의 문제입니다.
외부 측정: Artificial Analysis의 AA-WER v2
독립 기관인 Artificial Analysis의 비스트리밍 음성 인식 지표(AA-WER v2)에서는 Scribe v3가 1.9%, Scribe v2가 2.2%로 측정됐습니다. 이 지표는 상담 대화, 유럽의회 연설, 실적 발표 통화 세 가지 데이터셋을 합산한 것이며 2026년 11월 15일에 확인된 값입니다.
이 두 숫자의 관계를 정리하면 이렇습니다.
회사 수치는 102개 언어를 아우르는 평균이라 범위가 넓은 대신 자체 평가입니다. 외부 수치는 영어 위주의 3개 데이터셋이라 범위는 좁지만 제3자가 측정했습니다. 개선 폭도 다릅니다. 회사 수치는 4.56%p 하락(약 27% 감소), 외부 수치는 0.3%p 하락입니다. 외부 측정에서는 v2의 기준값이 이미 낮은 만큼 줄어들 여지 자체가 작았다는 점도 감안해야 합니다. 두 숫자를 한 문장으로 합쳐 "이만큼 좋아졌다"고 말하는 것은 피하는 편이 안전합니다.
화자 구분: 전체 12%, 3명 이상에서 17% 오류 감소
출시 발표에 따르면 녹음용 v3는 v2보다 화자 구분 오류가 전체에서 12% 줄었고, 화자가 3명 이상인 녹음에서는 17% 줄었습니다. 회사가 평가한 데이터 기준의 결과입니다.
흥미로운 지점은 화자가 많을수록 개선 폭이 컸다는 점입니다. 두 사람이 번갈아 말하는 인터뷰보다 여러 명이 섞여 있는 회의·좌담·포럼에서 체감 개선이 더 클 가능성을 시사합니다. 다만 이것은 회사가 평가한 데이터에서의 비율이므로, 내 녹음에서 같은 폭이 나온다고 단정할 수는 없습니다.
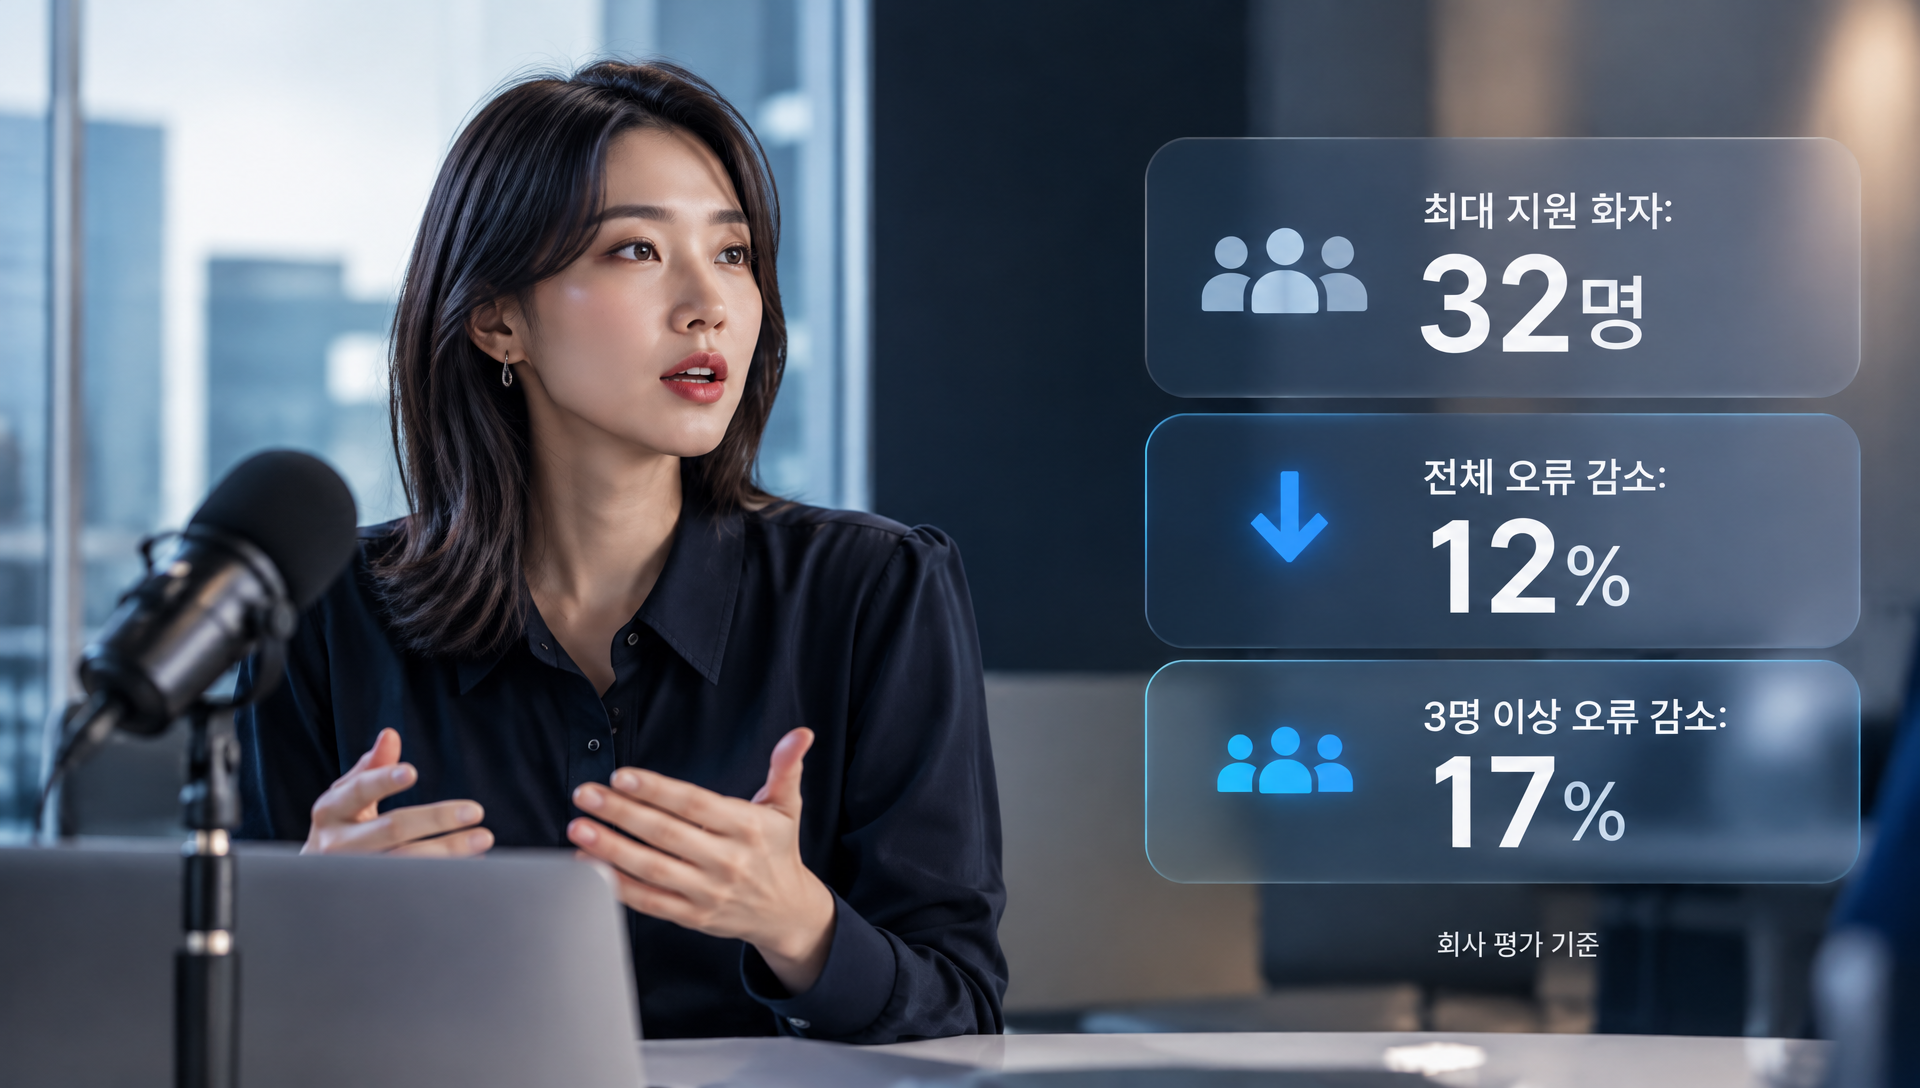
공식 문서는 Scribe v3가 최대 32명의 화자 구분과 단어·문자 단위 타임스탬프를 지원한다고 안내합니다. 여기서 구분해야 할 것이 있습니다. 32명은 지원 가능한 최대 인원이지, 겹쳐 말하거나 음질이 나쁜 실제 녹음에서 32명 각각을 정확히 식별한다는 보장이 아닙니다. 인원이 늘수록 한 사람의 발화 시간이 짧아지고 목소리를 구별할 단서도 줄어듭니다. 대규모 좌담 녹음을 다룬다면 상한 숫자보다 내 녹음 샘플의 실측 결과를 기준으로 삼으세요.
용어 지정과 숫자 표기
출시 발표는 v3가 숫자를 숫자 표기로 낼지 단어로 낼지 선택할 수 있고, 최대 1,000개의 용어를 지정할 수 있다고 설명합니다. 제품명, 인명, 전문 약어가 많은 녹음에서는 이 용어 목록이 정확도에 직접 영향을 줍니다. 금액·전화번호·날짜가 자주 나오는 통화 기록이라면 숫자 표기 방식도 후처리 부담을 가르는 요소입니다.
Scribe v3가 어울리는 경우와 한계
어울리는 경우:
· 회의·인터뷰·강연처럼 끝난 녹음을 파일로 받아 회의록이나 자막으로 만드는 작업
· 화자가 3명 이상인 녹음에서 화자 구분 정확도가 중요한 작업
· 전문 용어가 많아 대량의 용어 목록이 필요한 작업
한계:
· 실시간 화면 표시에는 쓰지 못합니다(파일 전사 API 기반이므로).
· 회사 수치와 외부 수치 모두 내 환경의 정확도를 보장하지 않습니다.
· 외부 측정이 영어 위주라 한국어를 포함한 개별 언어의 정확도는 별도로 확인해야 합니다.
실시간용 Scribe v3 Live: 실시간 화자 분리와 확정 전의 라벨
Scribe v3 Live의 핵심 변화는 실시간 화자 분리가 새로 들어왔다는 점이며, 이 기능은 "빨리 보이는 대신 나중에 고쳐질 수 있다"는 성격을 함께 가집니다. 스트리밍이라는 구조상 피할 수 없는 특성이므로, 장점과 함께 구현 주의점을 반드시 이해해야 합니다.
실시간 화자 구분 평가: 3.1% 대 5.9~7.3%
ElevenLabs가 공개한 영어 실사용 평가에서 v3 Live의 실시간 화자 구분 오류율은 3.1%였고, 비교한 다른 실시간 모델들은 5.9~7.3%였습니다. 차선 실시간 모델 대비 오류가 39% 감소했다는 표현이 이 비교에서 나왔습니다.
이 수치를 읽을 때 놓치기 쉬운 단서가 세 가지 있습니다.
첫째, ElevenLabs 자체 평가이며 독립 검증 결과가 아닙니다.
둘째, 단어를 정답 원고에 먼저 맞춘 뒤 화자 배정만 채점한 방식입니다. 단어 인식이 틀려서 생기는 오류는 이 숫자에 들어 있지 않습니다.
셋째, 이 방식 때문에 녹음용 화자 구분 결과와 직접 비교할 수 없다고 회사가 직접 밝힙니다. 녹음용의 "12% 감소"와 실시간의 "3.1%"는 서로 다른 자로 잰 값입니다.
실시간 WER: 43%와 44%가 다른 이유
실시간 WER 개선율은 공식 자료끼리도 표기가 다릅니다.
· 11월 14일 갱신된 출시 글: 102개 언어 FLEURS 기준으로 v2 Realtime 대비 semantic WER 43% 감소, 일반 WER 31% 감소
· 공식 모델 문서: 73개 언어 FLEURS 기준으로 semantic WER 44% 감소
두 자료 모두 semantic WER(단어 하나하나보다 의미 전달 여부를 반영하는 방식)을 말하지만, 언어 범위가 102개와 73개로 달라 43%와 44%를 하나의 숫자로 통일할 수 없습니다. 독자가 취할 태도는 단순합니다. "semantic WER 기준으로 약 40%대 감소"라는 대략적 방향만 받아들이고, 인용할 때는 어느 자료의 어느 언어 범위인지 함께 적으세요.
모델 문서는 영어 데이터셋 결과도 제시합니다.
· Earnings-22: WER 5.99%에서 3.91%로 감소
· VoxPopuli: WER 2.13%에서 1.71%로 감소
실적 발표 통화(Earnings-22) 쪽에서 개선 폭이 더 큽니다. 한편 실시간(v3 Live)의 독립 측정치는 이번 검토에서 확인하지 못했습니다. 녹음용에는 외부 측정이 있지만 실시간에는 없다는 점이 두 모델의 근거 수준 차이입니다.
화자 라벨은 확정 전에 바뀔 수 있다
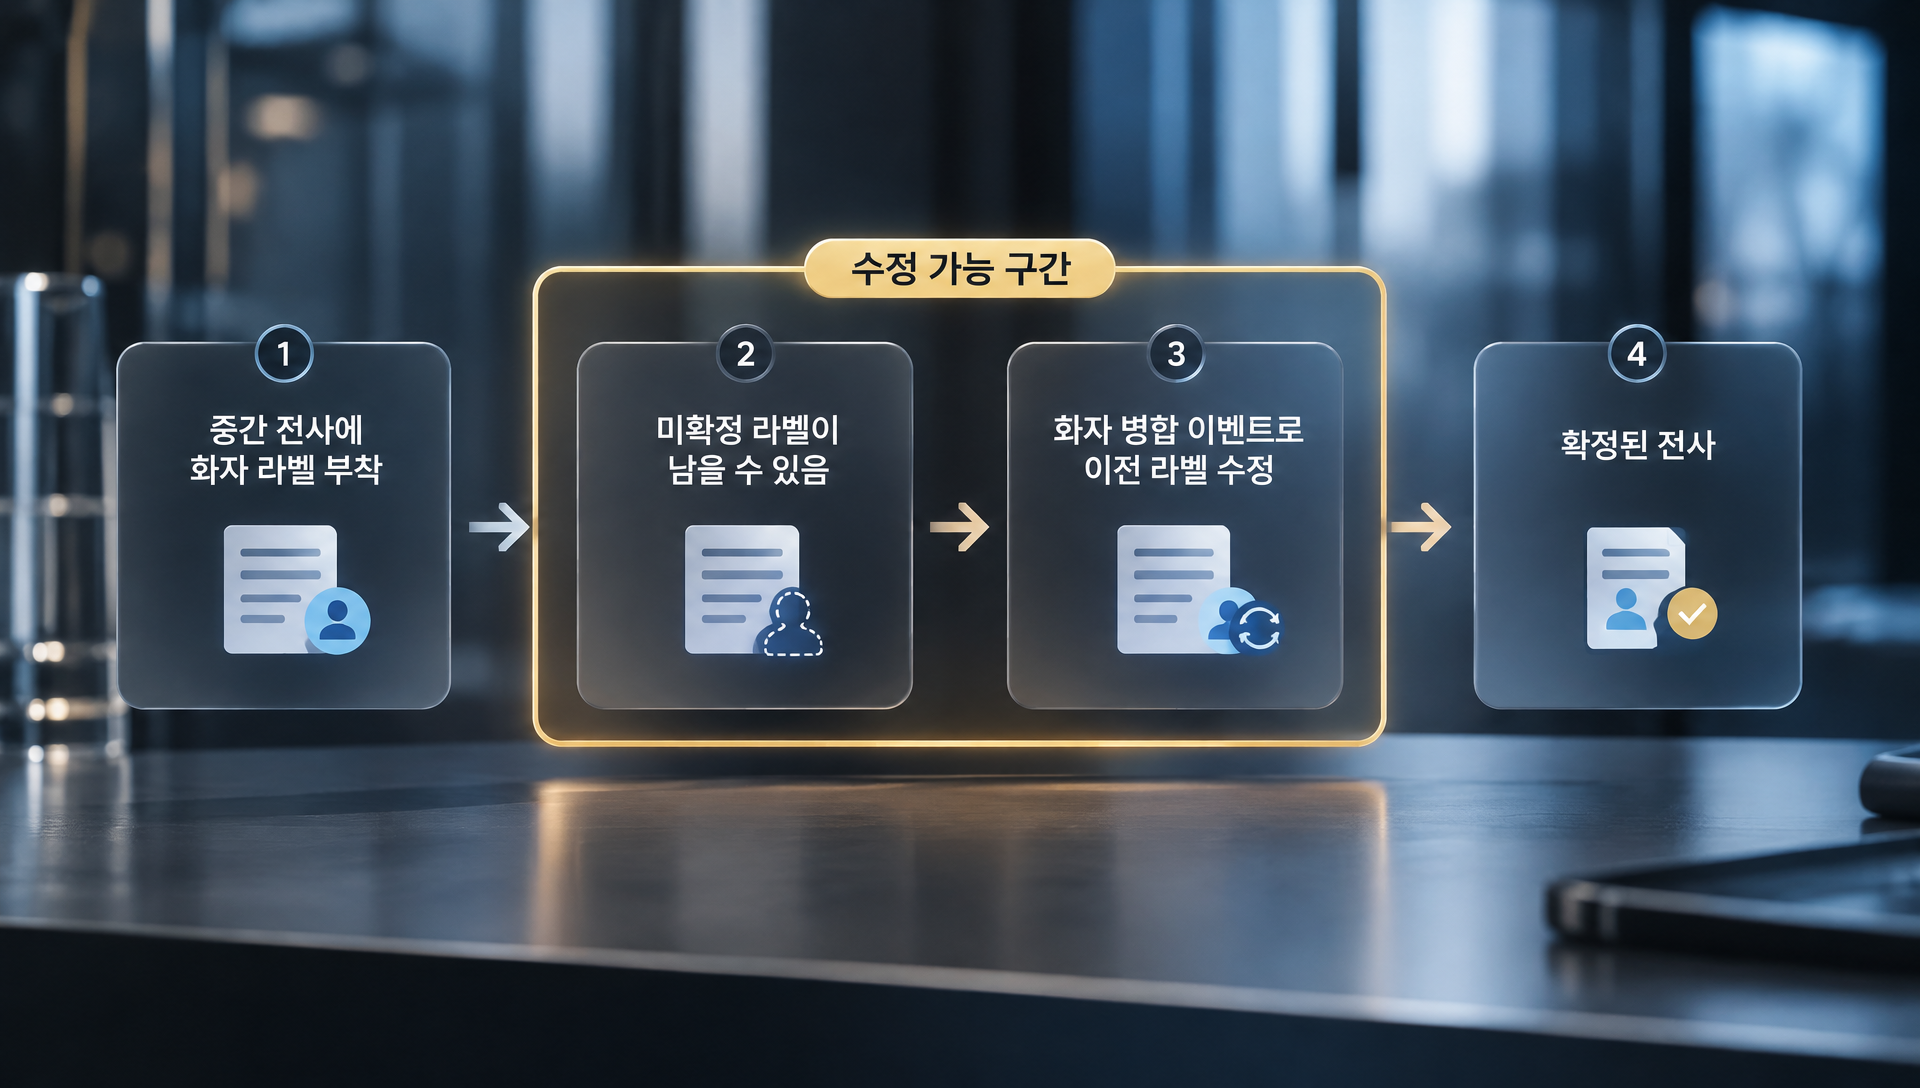
실시간 화자 분리를 쓰려면 API에서 model_id=scribe_v3_live와 diarize=true를 지정해야 합니다. 여기서 공식 가이드의 경고를 그대로 새겨야 합니다. 중간 전사에 붙은 화자 라벨이 뒤에서 바뀔 수 있고, 미확정 라벨이 남거나 화자 병합 이벤트로 이전 라벨이 수정될 수 있습니다.
예를 들어 회의 중 처음에는 한 사람이 "화자 1"로 표시되다가, 나중에 다른 목소리와 같은 사람으로 판단되어 라벨이 합쳐질 수 있습니다. 자막처럼 한 번 내보내면 끝인 출력에는 이 특성이 부담이 되고, 화면에 임시로 표시했다가 나중에 갱신할 수 있는 UI에서는 큰 문제가 아닙니다.
실무에서는 이렇게 대응합니다.
1. 중간 전사의 화자 라벨은 임시값으로 취급하고, 화면에는 갱신 가능한 형태로 표시합니다.
2. 데이터베이스나 외부 시스템에 저장하는 시점은 확정된 전사가 도착한 뒤로 미룹니다.
3. 화자 병합 이벤트를 받으면 이전에 표시·저장한 라벨을 수정하는 처리를 넣습니다.
4. 세션이 끝난 뒤 남아 있는 미확정 라벨을 정리하는 후처리 단계를 둡니다.
발화 종료 판단: turn prediction과 SDK 지원 확인
v3 Live의 turn prediction은 침묵이 일정 시간 이어졌는지만 보는 대신 대화 맥락을 사용해 발화가 끝났는지를 판단합니다. 말을 잠깐 멈춘 것과 말을 끝낸 것을 구분하는 데 도움이 되므로, 음성 에이전트나 통화 응대처럼 끼어들기 타이밍이 중요한 서비스에서 의미가 있습니다.
다만 구현에서 확인할 점이 있습니다.
· 공식 모델 문서상 기존 통합의 기본 commit 방식은 manual이며, turn prediction을 쓰려면 설정을 바꿔야 합니다.
· 모델 문서는 공식 SDK가 turn prediction, 다국어 모드, 용어 라이브러리를 아직 지원하지 않으므로 WebSocket에 직접 연결하라고 안내합니다.
· 반면 출시 글의 예시 코드는 JS SDK에서 commitStrategy "turn_prediction"을 지정합니다.
공식 자료끼리 안내가 어긋나므로, 구현에 들어가기 전에 사용하는 SDK 버전이 해당 기능을 지원하는지부터 확인하세요. 지원 여부가 불확실하면 WebSocket에 직접 연결하는 쪽이 모델 문서의 안내와 일치합니다.
언어 전환과 용어 입력
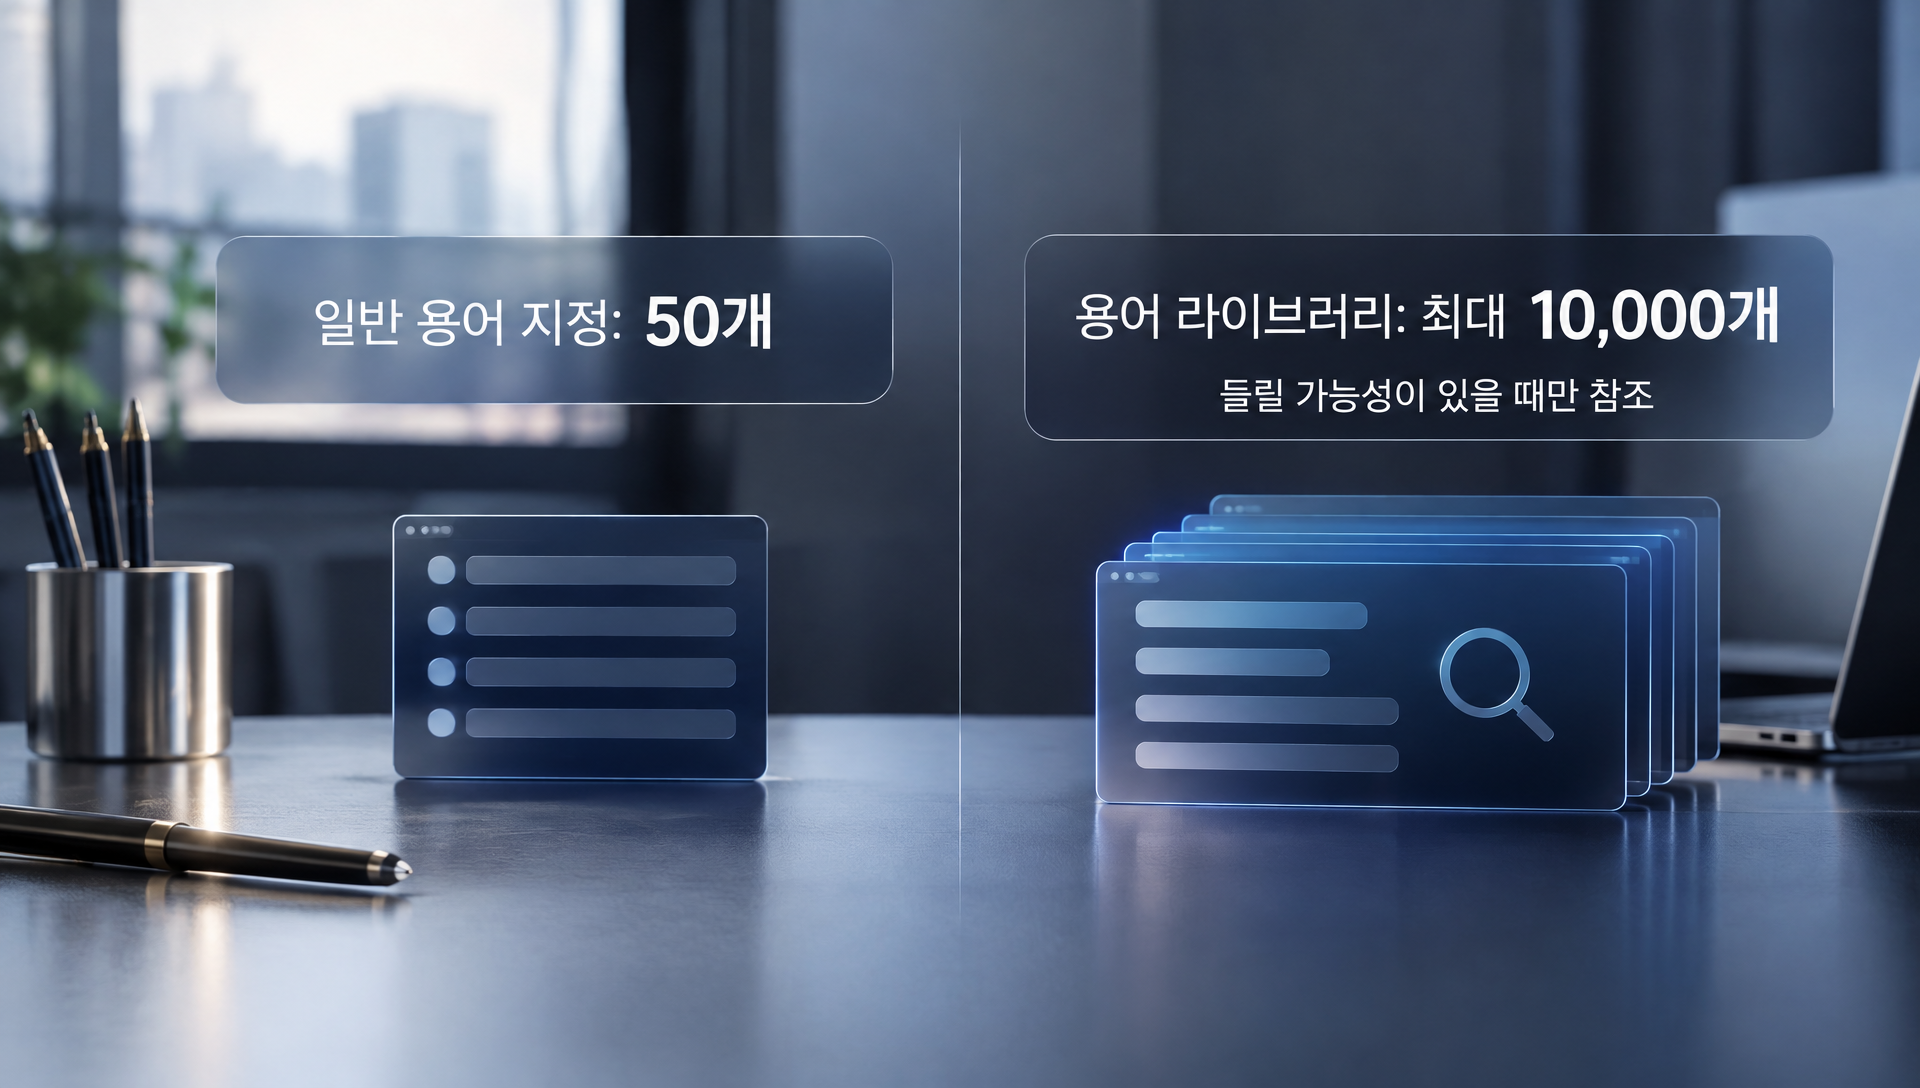
v3 Live는 문장 중간에 언어가 바뀌는 상황을 위한 다국어 모드와 별도의 용어 라이브러리를 제공합니다. 모델 문서 기준 수치는 다음과 같습니다.
· 일반 용어 지정: 50개
· 용어 라이브러리: 최대 10,000개 (소리가 들릴 가능성이 있을 때만 참조)
녹음용 v3의 1,000개 지정 방식과 구조가 다르다는 점이 중요합니다. 일반 지정은 50개로 적지만, 라이브러리는 훨씬 많은 용어를 담되 해당 용어가 들릴 가능성이 있을 때만 참조하는 방식입니다. 따라서 핵심 용어 소수는 일반 지정에, 방대한 용어 사전은 라이브러리에 나누어 넣는 설계가 자연스럽습니다.
Scribe v3 Live가 어울리는 경우와 한계
어울리는 경우:
· 통화·상담·회의 중 말하는 동안 화면에 바로 문장이 나와야 하는 서비스
· 음성 에이전트처럼 발화 종료 시점을 맥락으로 판단해야 하는 서비스
· 대화 중 화자별로 나눈 임시 기록을 실시간으로 보여 줘야 하는 서비스
한계:
· 화자 라벨이 확정 전에 바뀔 수 있어 저장·출력 설계에 후처리가 필요합니다.
· 공식 SDK와 turn prediction 지원이 문서마다 달라 구현 전 확인이 필요합니다.
· 독립 측정치가 아직 확인되지 않아 정확도 근거는 회사 자체 평가에 의존합니다.
기준별로 본 두 모델의 차이
아래 표는 다섯 가지 기준 가운데 텍스트로 비교가 가능한 항목을 한 번에 모았습니다. 점수를 매긴 것이 아니라 차이를 나열한 것입니다.
| 구분 | Scribe v3 (녹음) | Scribe v3 Live (실시간) |
|---|---|---|
| 후속 관계 | Scribe v2의 후속 | Scribe v2 Realtime의 후속 |
| 통로 | 파일 전사 API | 실시간 WebSocket |
| 화자 구분 | 최대 32명 지원, v2 대비 오류 전체 12%·3명 이상 17% 감소(회사 평가) | 실시간 화자 분리 신규, 영어 실사용 평가 오류율 3.1%(회사 평가) |
| 라벨 확정 | 파일 전체 처리 후 결과 제공 | 중간 라벨이 수정될 수 있고 병합 이벤트 발생 가능 |
| 용어 지정 | 최대 1,000개, 숫자 표기 선택 | 일반 50개, 용어 라이브러리 최대 10,000개, 다국어 모드 |
| 정확도 근거 | FLEURS 102개 언어 WER 16.94%→12.38%, 외부 AA-WER v2 1.9% | 출시 글 semantic WER 43%(102개 언어), 모델 문서 44%(73개 언어) |
| 독립 측정 | 있음(영어 위주 3개 데이터셋) | 이번 검토에서 확인하지 못함 |
표를 읽는 법: 같은 행이라도 두 칸의 숫자를 서로 직접 견주지 마세요. 화자 구분 행의 "12% 감소"와 "3.1%"는 채점 방식이 달라 비교할 수 없고, 정확도 근거 행의 WER들도 데이터셋과 언어 범위가 다릅니다.
상황별 선택 기준
처리 시점이 선택의 첫 번째 갈림길이고, 화자 구분과 데이터 위치가 두 번째 갈림길입니다. 아래는 대표적인 상황별 기준입니다.
① 끝난 회의·인터뷰·강연 녹음을 문서로 만든다
Scribe v3가 맞습니다. 파일 전체를 처리하므로 화자 라벨 수정에 신경 쓸 필요가 없고, 화자가 3명 이상이면 회사가 밝힌 화자 구분 개선 폭도 더 큽니다.
② 영상 자막을 만들고 화자별 구분이 필요하다
Scribe v3가 맞습니다. 단어·문자 단위 타임스탬프를 지원하므로 자막 싱크 작업과 잘 맞습니다.
③ 통화나 회의 중 실시간으로 문장을 띄워야 한다
Scribe v3 Live가 맞습니다. 다만 화면에는 임시 라벨을 표시하고 저장은 확정 뒤로 미루는 설계가 필요합니다.
④ 음성 에이전트가 사용자의 말이 끝난 시점을 맥락으로 판단해야 한다
Scribe v3 Live의 turn prediction이 후보입니다. 사용 중인 SDK의 지원 여부를 먼저 확인하고, 불확실하면 WebSocket 직접 연결을 검토하세요.
⑤ 영어와 다른 언어가 한 문장 안에서 섞인다
Scribe v3 Live의 다국어 모드가 해당 상황을 위해 만들어진 기능입니다. 녹음 파일이라면 같은 상황을 Scribe v3로 처리해 보고 결과를 비교하는 방법이 있습니다.
⑥ 전문 용어가 수천 개 이상이다
실시간이라면 용어 라이브러리(최대 10,000개), 녹음이라면 용어 지정(최대 1,000개)을 기준으로 설계합니다. 용어 수가 한도를 넘으면 자주 나오는 용어부터 우선순위를 정합니다.
⑦ 같은 콘텐츠를 실시간으로도, 사후 정리로도 쓴다
두 모델을 병행하는 구성이 가능합니다. 실시간 화면용은 v3 Live, 확정 기록물은 같은 녹음을 v3로 다시 처리하는 방식입니다. 모델 ID만 scribe_v3와 scribe_v3_live로 바꾸면 전환할 수 있다고 출시 발표가 설명합니다.
내 환경에서 직접 검증하는 4단계
회사 수치와 외부 수치 모두 내 녹음의 정확도를 보장하지 않으므로, 도입 전 소규모 검증을 권합니다.
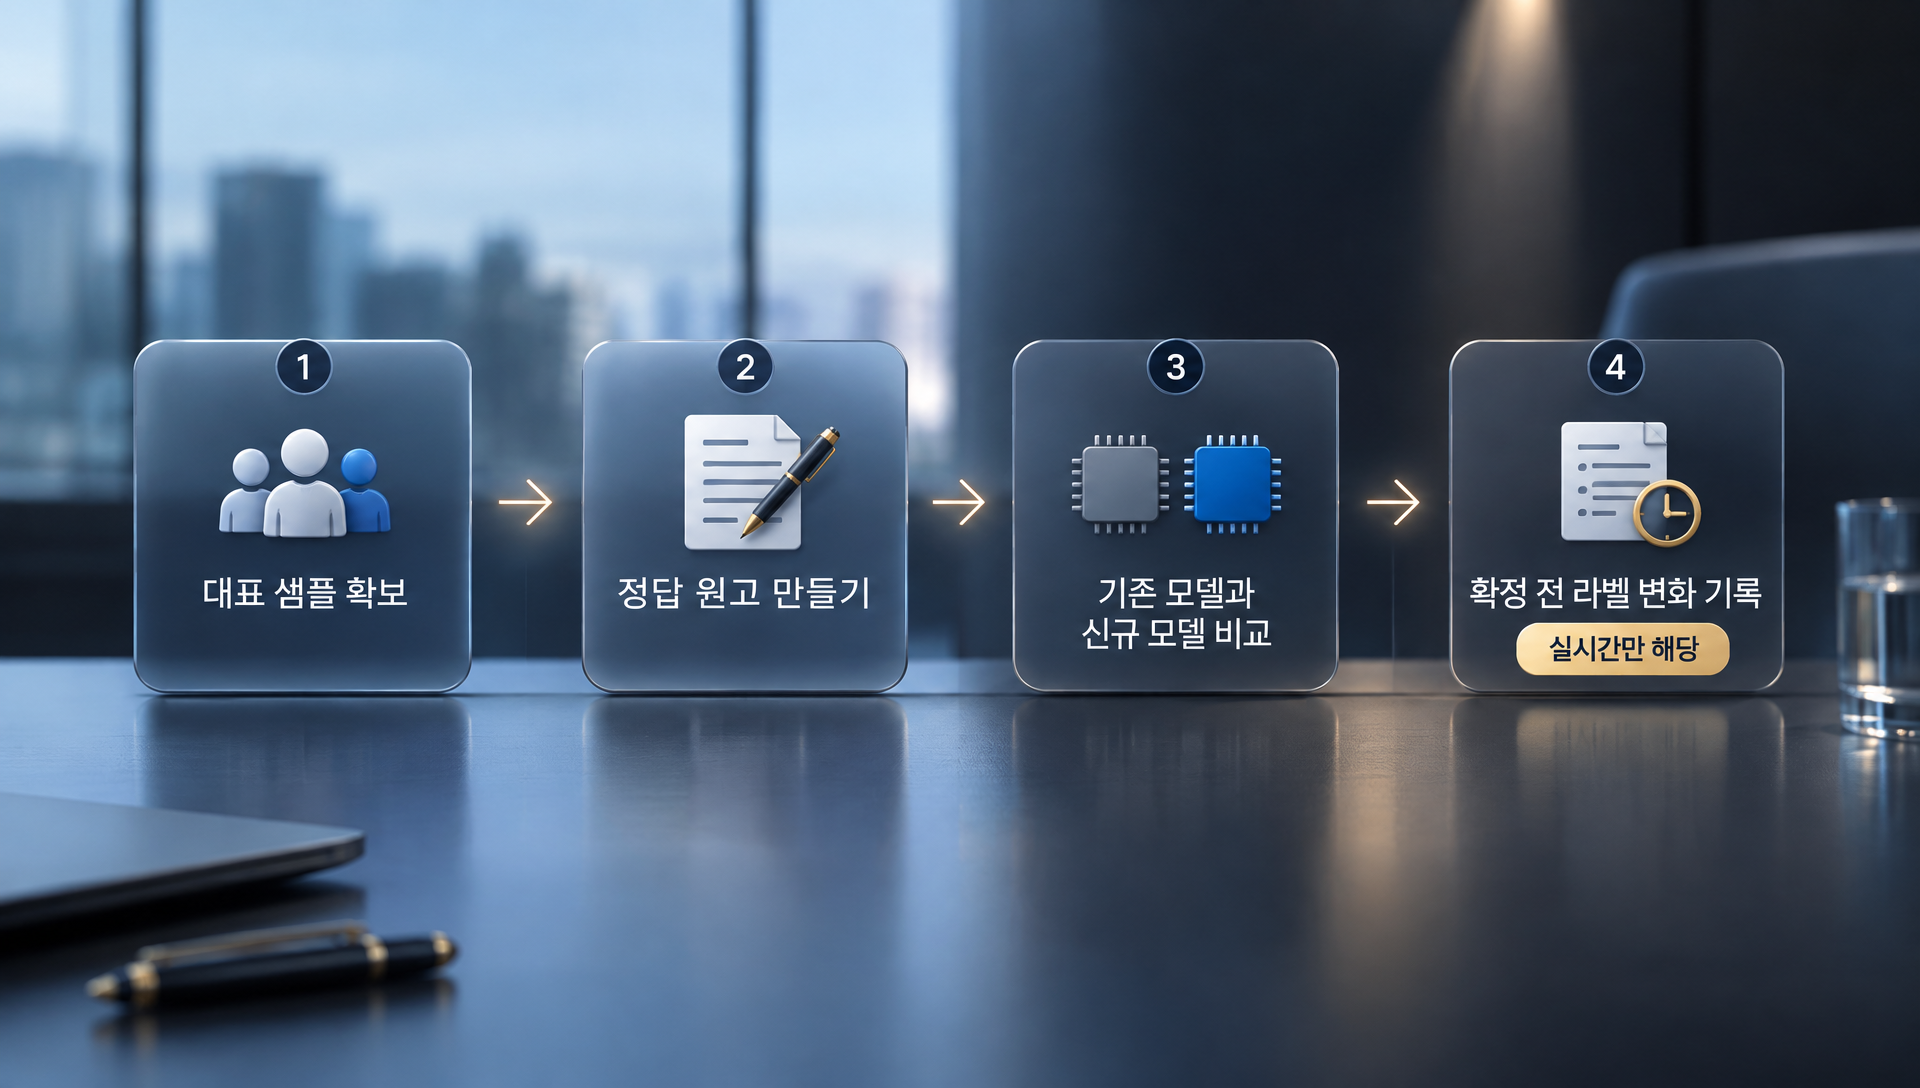
1단계: 대표 샘플 확보
실제 업무 녹음 중 조용한 것, 잡음이 있는 것, 화자가 많은 것을 섞어 10건 안팎을 고릅니다.
2단계: 정답 원고 만들기
사람이 직접 받아쓴 기준 원고를 만들고, 화자 구간도 표시해 둡니다.
3단계: 같은 샘플로 기존 모델과 신규 모델 비교
Scribe v2와 v3(실시간이라면 v2 Realtime과 v3 Live)에 같은 샘플을 넣고, 틀린 단어와 화자 배정 오류를 따로 셉니다. 단어 오류와 화자 오류를 분리해서 세는 것이 중요합니다. 회사의 실시간 화자 평가도 이 둘을 분리했기 때문입니다.
4단계: 확정 전 라벨 변화 기록 (실시간만 해당)
v3 Live라면 세션 중 화자 라벨이 몇 번, 어느 시점에 바뀌는지 로그로 남겨 저장·표시 설계에 반영합니다.
데이터 처리 위치와 보관
음성에는 개인정보가 담기기 쉬우므로, 처리 위치와 보관 방식을 도입 전에 확인해야 합니다. 두 모델은 기본적으로 미국에서 처리됩니다. 데이터 보관 위치 요구가 있는 기업 고객에게는 EU, 인도, 싱가포르의 격리 환경을 제공합니다. 한국 리전은 공식 발표에서 확인되지 않습니다.
Zero Retention Mode에서는 요청이 끝나는 즉시 음성과 텍스트를 삭제한다고 회사는 밝혔습니다. 국내 사내 규정이나 계약상 해외 이전에 제약이 있다면, 격리 환경 제공 대상 여부와 Zero Retention Mode 적용 여부를 도입 검토 단계에서 먼저 확인하세요.
자주 묻는 질문
기존 Scribe v2와 v2 Realtime은 바로 쓸 수 없게 되나요?
공식 발표 기준으로 ElevenLabs 앱에서는 두 새 모델이 기본값이 되었지만, 기존 Scribe v2와 v2 Realtime도 계속 제공됩니다. 서둘러 전환하기보다 샘플 검증을 마친 뒤 모델 ID를 바꾸는 순서로 진행해도 됩니다.
실시간 화자 구분의 3.1%를 그대로 믿어도 되나요?
그대로 일반화하기는 어렵습니다. 영어 실사용 평가에서 회사가 낸 자체 결과이고, 단어를 정답에 맞춘 뒤 화자 배정만 채점한 방식입니다. 독립 검증 결과도 아닙니다. 참고 방향으로 삼고, 내 녹음에서의 실측으로 확인하세요.
한 번 이용 가능한 곳은 어디인가요?
출시 발표는 v3 Live가 ElevenAgents에서, 두 모델 모두 ElevenAPI에서 이용 가능하다고 밝혔습니다. 앱에서는 두 모델이 기본값입니다.
숫자보다 어떤 숫자인지를 먼저 보세요
Scribe v3와 Scribe v3 Live는 이름이 비슷하지만 풀어야 하는 문제가 다릅니다. 녹음용은 정확도와 32명 화자 구분, 대량 용어 지정이 강점이고 외부 측정까지 확보되어 있습니다. 실시간용은 실시간 화자 분리와 맥락 기반 발화 종료 판단이 새 기능이지만, 라벨이 확정 전에 바뀔 수 있고 SDK 지원이 문서마다 달라 구현 단계의 확인이 더 많이 필요합니다.
정리하면 세 가지입니다.
· 녹음과 실시간의 정확도 숫자는 서로 비교하지 않는다.
· 회사 자체 평가는 방향으로 읽고, 내 샘플로 확인한다.
· 실시간 화자 라벨은 임시값으로 다루고, 저장은 확정 뒤에 한다.
이 세 가지만 지켜도 발표 수치에 끌려가지 않고 상황에 맞는 모델을 고를 수 있습니다.
📧 sales@vizensoft.com | 🌐 www.vizensoft.com | 📞 02-338-4610